Centralized vs Distributed Processing: Differences, Architecture, Performance & Use Cases
Understand centralized vs distributed processing with differences, architecture, performance, scalability, and real-world use cases in data engineering.
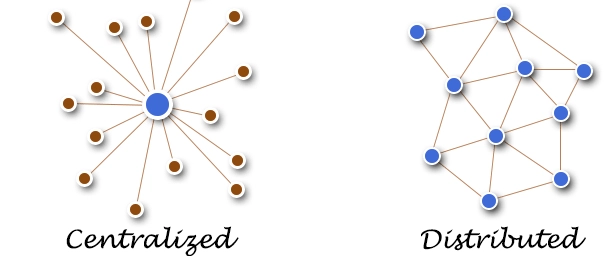
Centralized Processing
Distributed Processing
Side-by-Side Technical Matrix
Direct evaluation across performance, complexity, latency, and data modeling parameters.
| Evaluation Criterion | Centralized Processing | Distributed Processing |
|---|---|---|
| Architecture | Single node | Multiple nodes |
| Scalability | Limited | Highly scalable |
| Performance | Limited by hardware | Parallel processing |
| Fault Tolerance | Low | High |
| Complexity | Low | High |
| Cost | Lower (initial) | Higher (setup) |
| Use Case | Small systems | Big data systems |
Core Concepts & Architecture Workflows
Foundational definition, data flow patterns, and architectural mechanics for each system.
What is Centralized Processing?
Paradigm ACentralized Processing means:
- All computation happens in a single system
- One machine handles:
- - Storage
- - Processing
- - Queries
Examples - Traditional databases - Single-node applications
Key Idea 👉 Simple but limited
Centralized Flow
Users → Single Server → Processing → Output
What is Distributed Processing?
Paradigm BDistributed Processing means:
- Workload is split across multiple machines (nodes)
- Systems work together to process data
Examples
- Spark
- Hadoop
- Distributed databases
Key Idea
👉 Scale horizontally
Distributed Flow
Users → Cluster → Parallel Processing → Output
Real-World Implementation, Queries & Architecture Code
Concrete SQL queries and pipeline implementation patterns.
Example (Real-World Scenario)
Centralized Example
Single Database → Handles all user queries → Limited scale
Distributed Example
Data split across nodes → Parallel processing → Faster results
Example Code (Conceptual)
Centralized Processing
SELECT
    region,
    SUM(sales)
FROM sales
GROUP BY region;
👉 Runs on single machine
Distributed Processing (Spark Style)
SELECT
    region,
    SUM(sales)
FROM distributed_sales
GROUP BY region;
👉 Runs across multiple nodes
Performance Reality
Real-world throughput, latency constraints, and operational cost trade-offs.
When to Use Centralized vs Distributed
Guidelines for selecting the optimal architecture based on system requirements.
Use Centralized when:
- Small datasets
- Simple applications
- Low concurrency
Use Distributed when:
- Big data (TBs/PBs)
- High scalability required
- Real-time or heavy workloads
Common Mistakes 🚨
Avoid costly anti-patterns, misconfigurations, and system design oversights.
❌ Using Distributed for Small Problems
- Over-engineering
- Unnecessary complexity
❌ Ignoring Fault Tolerance
- Leads to system failures
❌ Poor Data Partitioning
- Causes performance bottlenecks
Interview Angle 🔥
Essential questions and key talking points frequently asked in staff/senior interviews.
💡 1. Difference between centralized and distributed systems?
+💡 2. Why use distributed processing?
+💡 3. Challenges in distributed systems?
+💡 4. Example tools?
+FAQ
Direct answers to common architecture queries.
❓ What is centralized processing?
+❓ What is distributed processing?
+❓ Which is better centralized or distributed?
+❓ Why are distributed systems popular?
+Key Architectural Summary
Quick recap of primary characteristics and core takeaways.
Centralized
- Single system
- Easy to manage
- Limited scalability
- Low complexity
Distributed
- Multiple nodes
- Highly scalable
- Fault tolerant
- Complex architecture
Data Processing Architecture (Critical 🔥)
Detailed architectural insights and system considerations.
Centralized Architecture
- Vertical scaling (increase CPU/RAM)
- Single point of failure
- Easier to manage
👉 Example:
- One database server handling all queries
Distributed Architecture
- Horizontal scaling (add nodes)
- Fault-tolerant
- Data partitioning & parallelism
👉 Example:
- Spark cluster processing TBs of data